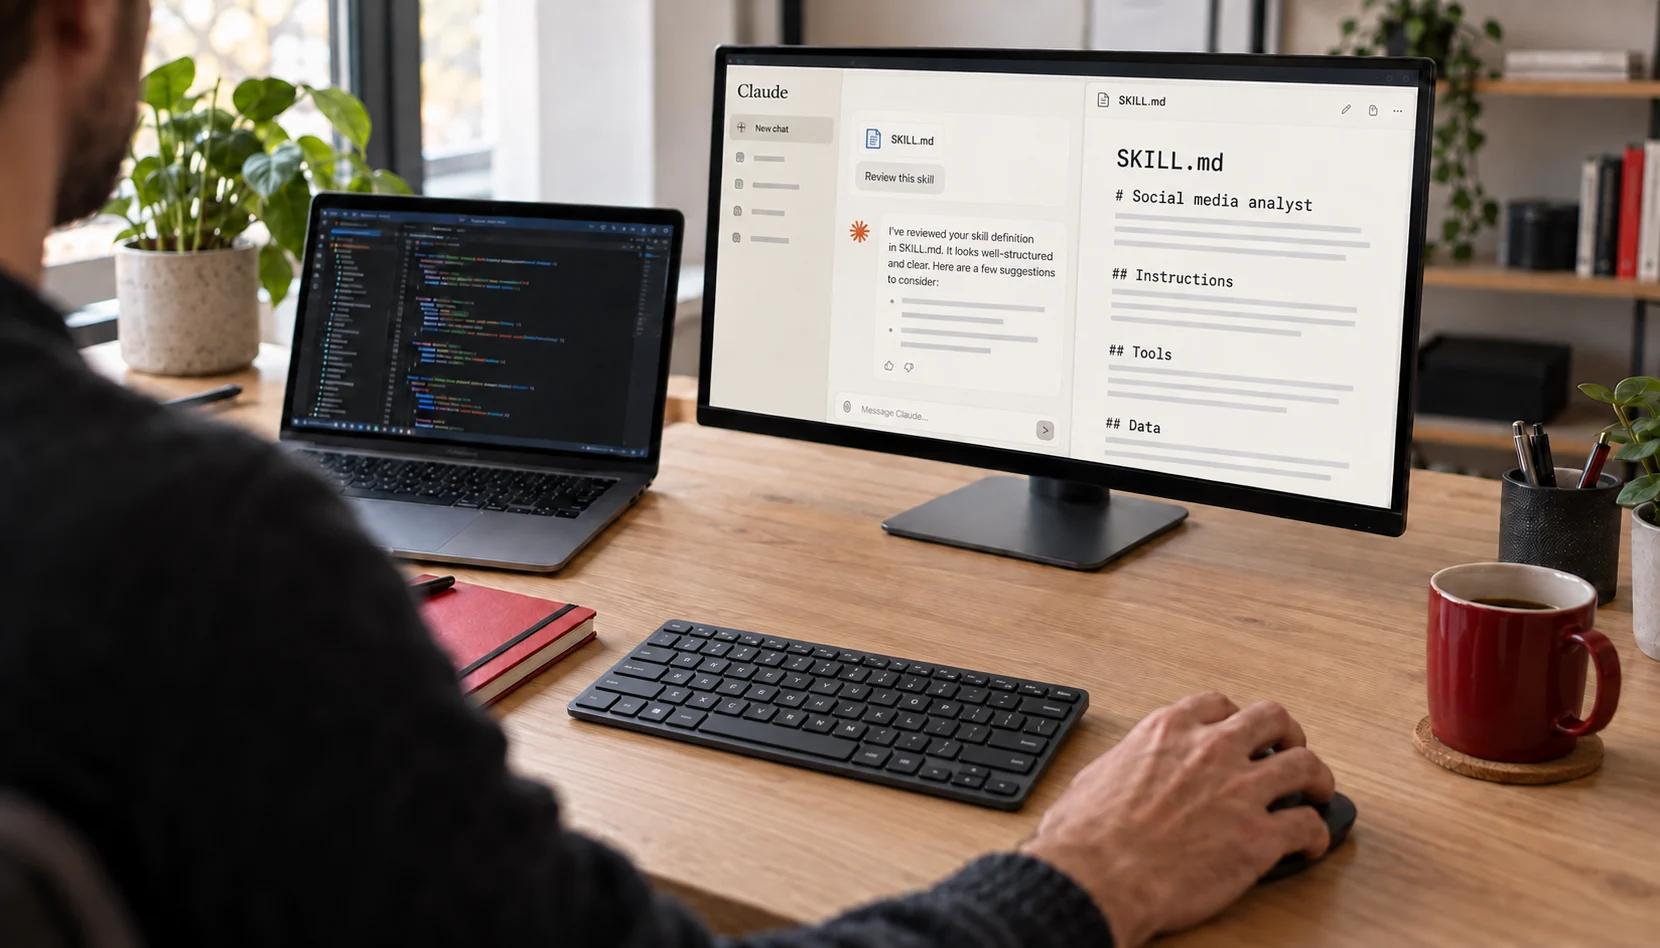
À nos yeux, les fichiers de compétences sont des prompts sous une forme plus élaborée. Ils reprennent des instructions que vous auriez autrement copiées et collées, les organisent dans un fichier structuré et facilitent leur réutilisation.
C’est utile. Vous pouvez définir une procédure une fois, la rappeler et l’améliorer avec l’expérience. Une compétence peut expliquer quels outils utiliser, où se trouvent les données et comment évaluer le résultat.
Mais le fichier n’est qu’une partie du système. Si un agent a besoin de données d’entreprise à jour, il faut les collecter et les stocker. S’il a besoin d’un calcul, quelque chose doit l’exécuter. Si le travail doit avoir lieu chaque jour, un processus en fonctionnement doit le déclencher.
Ces éléments méritent autant d’attention que les instructions. Nous dirions même qu’ils en méritent beaucoup plus que le fichier de compétences lui-même. Ils devraient aussi pouvoir fonctionner indépendamment de l’assistant IA utilisé par votre entreprise.
Qu’est-ce que SKILL.md et à quoi servent les Claude Skills ?
SKILL.md est le fichier d’entrée d’une compétence d’agent. Il précise quand la compétence s’applique et comment l’agent doit aborder la tâche. Les Claude Skills peuvent aussi inclure des scripts, des modèles et des documents de référence. 1 2
Une compétence d’analyse des réseaux sociaux peut, par exemple, demander à l’agent de lire le contexte de l’entreprise, de récupérer l’activité des concurrents, de comparer les résultats et de proposer des idées de contenu avec des sources à l’appui.
Un script fourni peut prendre en charge une partie de ce travail. Mais ajouter la compétence à Claude ou à ChatGPT ne crée pas, à lui seul, un stockage partagé ni un processus de collecte qui continue après la fermeture de la conversation.
Pour une tâche métier, vérifiez quels systèmes la compétence peut réellement consulter et dans lesquels elle peut agir.
La collecte régulière de données devrait fonctionner seule
Nous développons un agent de réseaux sociaux pour Swiss Product Studio. Il a besoin de publications de concurrents, d’informations sur leurs comptes et de mesures collectées à des moments connus.
Il y a peu de raisons de demander à un modèle de langage de décider, toutes les quelques heures, de récupérer les mêmes comptes et d’enregistrer les résultats. Une fois les sources et les règles définies, il s’agit d’une tâche d’automatisation classique.
Un workflow n8n planifié peut s’en charger. Un collecteur développé sur mesure et hébergé dans le cloud convient aussi. L’essentiel est d’avoir un processus qui récupère les données, traite les erreurs et enregistre le résultat. Le Schedule Trigger de n8n déclenche, par exemple, des workflows à intervalles réguliers ou à des heures définies. 3
Interroger un point d’accès connu, vérifier les identifiants, supprimer les doublons et enregistrer des données ne nécessite pas d’appel à un modèle de langage. La collecte courante n’a pas besoin de consommer vos crédits Claude ou OpenAI.
Utilisez l’IA quand l’interprétation apporte quelque chose : comprendre une tendance dans les données, évaluer une source ou développer une idée. Le collecteur peut poursuivre sa tâche définie en arrière-plan.
Les données d’entreprise ont besoin d’un stockage partagé
Où vont les données après leur collecte ?
Pour une expérimentation, enregistrer des fichiers sur votre ordinateur est pratique. Pour un processus d’entreprise utilisé par plusieurs personnes, agents et outils, une base de données partagée constitue une meilleure fondation.
L’agent de réseaux sociaux peut consulter les mêmes enregistrements qu’un tableau de bord. Un autre assistant peut les utiliser pour un rapport. Une application autorisée permet d’y accéder depuis un ordinateur ou un téléphone, sans dépendre d’une conversation particulière ni de l’ordinateur d’une seule personne.
L’historique reste aussi disponible lorsque vous changez d’assistant. Votre entreprise utilise peut-être Claude aujourd’hui et un agent reposant sur OpenAI dans six mois. Une base de données gérée séparément et un processus de collecte indépendant donnent aux deux le même point de départ.
Vous devrez peut-être adapter un connecteur ou une interface d’outil. Vous ne devriez pas avoir à reconstituer tout l’historique de l’entreprise parce que vous changez le modèle qui le consulte.
Un bon modèle de données rend les enregistrements utiles
Une base de données demande plus de réflexion qu’un simple emplacement pour la sortie du collecteur. Son modèle définit ce que représentent les enregistrements et les liens entre eux.
Pour l’agent de notre studio, nous avons séparé la marque à promouvoir, les entreprises ou personnes suivies, leurs comptes sociaux, leurs publications et les observations recueillies pour chaque publication.
La date de publication d’un contenu et la date de collecte d’une mesure sont deux faits distincts. En les conservant séparément, l’agent peut distinguer une publication parue hier d’un ancien contenu mesuré hier. Des observations répétées permettent ensuite de comparer l’évolution dans le temps.
Les relations comptent aussi. Une entreprise peut posséder plusieurs comptes. Un compte peut publier de nombreux contenus. Une publication peut faire l’objet de plusieurs mesures. Des identifiants stables relient ces enregistrements sans obliger le modèle à rapprocher les noms à chaque requête.
Lors de notre première analyse, nous avons aussi trouvé une publication personnelle dans le fil d’une entreprise. Avant de comparer ses interactions au nombre d’abonnés de l’entreprise, nous devions vérifier qui en était l’auteur. Les enregistrements et les références aux sources ont rendu cette vérification possible. Une bonne instruction n’aurait pas suffi à fournir l’attribution manquante.
Le même raisonnement s’applique aux clients, factures, projets et réunions. Définissez les entités, relations, dates et règles métier pour que l’agent puisse interroger des données qui ont du sens. AWS décrit le vocabulaire commun, les relations et les définitions des indicateurs comme une partie du contexte métier dont les agents ont besoin pour comprendre les données. 4
Confiez les calculs à SQL
Si vos données numériques sont dans une base de données, utilisez celle-ci pour les calculs.
Un agent peut traduire une question comme « Quel compte avait le taux d’interaction médian le plus élevé le mois dernier ? » en une requête adaptée, ou appeler un outil qui exécute un calcul défini. SQL filtre les enregistrements, relie les tables pertinentes et calcule le résultat. Le modèle de langage peut ensuite l’expliquer.
Vous obtenez ainsi un calcul vérifiable et reproductible. PostgreSQL propose des fonctions d’agrégation pour les comptages, sommes, moyennes et calculs statistiques, ainsi que des types numériques pour les valeurs exigeant une précision définie. 5 6
La requête et la définition métier doivent toujours être correctes. Diviser les interactions d’une publication personnelle par le nombre d’abonnés d’une entreprise reste une mauvaise comparaison, même si SQL exécute parfaitement l’opération.
Pour notre analyse des réseaux sociaux, nous avons utilisé un script de calcul et vérifié les résultats de manière indépendante avec SQL. Le principe reste le même : exécuter les calculs dans un logiciel plutôt que demander au modèle de langage de produire un nombre à partir de son raisonnement.
Une compétence peut documenter la formule et ses conditions d’utilisation. Une requête testée ou un outil de calcul effectue le travail.
Base de données vectorielle, vector embeddings et RAG
Prenons maintenant les transcriptions de réunions. Avec des centaines de longues conversations, fournir à nouveau tout le texte brut à un assistant pour retrouver une seule discussion n’est pas un bon choix par défaut.
Vous pouvez conserver les transcriptions originales, les découper en sections utiles et enregistrer chaque section avec l’identifiant de la réunion, sa date, les intervenants et une référence à son emplacement dans le texte original. Les vector embeddings, ou représentations vectorielles, traduisent le sens du texte en nombres. Le système peut ainsi retrouver des sections pertinentes même si la question emploie d’autres mots. La recherche par mots-clés peut compléter cette recherche sémantique. 7
Les vector embeddings peuvent être stockés dans une base de données vectorielle ou dans une base relationnelle prenant en charge les vecteurs. 7
Cela permet la génération augmentée par récupération, ou RAG (retrieval-augmented generation) : le système récupère des informations pertinentes de l’entreprise et les transmet au modèle de langage comme contexte pour sa réponse. Les vector embeddings aident à retrouver ces informations. Le RAG désigne le processus plus large qui utilise les informations récupérées pour générer une réponse. 4
Par exemple, une question sur les objections d’un client concernant le prix peut d’abord limiter la recherche aux réunions de ce client, puis récupérer les sections pertinentes. L’agent peut s’en servir pour répondre et renvoyer aux transcriptions originales si quelqu’un veut vérifier le contexte.
C’est aussi une décision de modélisation : comment organiser le texte, quelles métadonnées le relient à l’activité et comment contrôler l’accès. Pour quelques documents, une recherche textuelle classique peut suffire. Un fonds documentaire plus vaste et varié peut bénéficier d’une recherche sémantique ou hybride.
La création de vector embeddings peut elle-même utiliser un modèle et entraîner un coût. Il s’agit d’une étape de traitement distincte et définie, plutôt que de demander à l’agent conversationnel de relire tout le fonds à chaque question.
Gardez les systèmes indépendants de l’assistant
L’architecture que nous viserions sépare quatre responsabilités :
| Élément | Rôle |
|---|---|
| Processus planifiés | Collecter et actualiser les données selon des règles définies |
| Base de données partagée | Conserver les enregistrements, relations, références aux sources et l’historique |
| Outils | Récupérer les données autorisées, exécuter les calculs et effectuer des actions contrôlées |
| Compétences | Expliquer à l’agent comment utiliser ces capacités pour une tâche précise |
Avec ces éléments, différents assistants peuvent utiliser les mêmes systèmes métier. Claude analyse les données aujourd’hui. Un agent reposant sur OpenAI peut les utiliser plus tard. Un tableau de bord peut les interroger sans faire intervenir de modèle de langage.
Cette séparation facilite aussi l’amélioration de la compétence. Vous pouvez affiner les étapes d’analyse, ajouter un meilleur exemple ou changer le format attendu, tandis que le collecteur continue à fonctionner et que la base conserve son historique.
La compétence devient une manière réutilisable de travailler avec le système que vous avez construit.
Améliorez la compétence avec le système
Les compétences sont utiles. Elles facilitent le partage, la répétition et l’amélioration des procédures. Mais construire un agent fiable implique aussi de décider quelles tâches relèvent de l’automatisation classique, où résident les données d’entreprise et quels outils les rendent accessibles.
Pour l’agent de notre studio, la valeur vient de la connexion entre ces éléments : processus de collecte, données structurées, analyses reproductibles et instructions qui aident l’assistant à transformer les résultats en propositions utiles.
Commencez par une tâche et identifiez sa source de données, sa fréquence de collecte, son stockage et les outils nécessaires. Continuez à améliorer le fichier de compétences, pendant que ces systèmes restent utiles après la fin de la conversation ou un changement de modèle.
Sources
- Anthropic : équiper les agents pour des tâches réelles avec Agent Skills. Instructions, chargement progressif et scripts intégrés. ↑1
- Spécification Agent Skills. Fichier d’entrée obligatoire et ressources facultatives. ↑1
- n8n : Schedule Trigger. Exécuter des workflows publiés à des intervalles et heures définis. ↑1
- AWS : construire une fondation de données pour l’IA agentique. Relations, définitions des indicateurs, actualité et sens métier. ↑1 ↑2
- PostgreSQL : fonctions d’agrégation. Calculs sur des ensembles d’enregistrements. ↑1
- PostgreSQL : types numériques. Entiers, nombres exacts et nombres à virgule flottante. ↑1
- Supabase : recherche sémantique. Embeddings, recherche par sens et combinaison avec la recherche par mots-clés. ↑1 ↑2