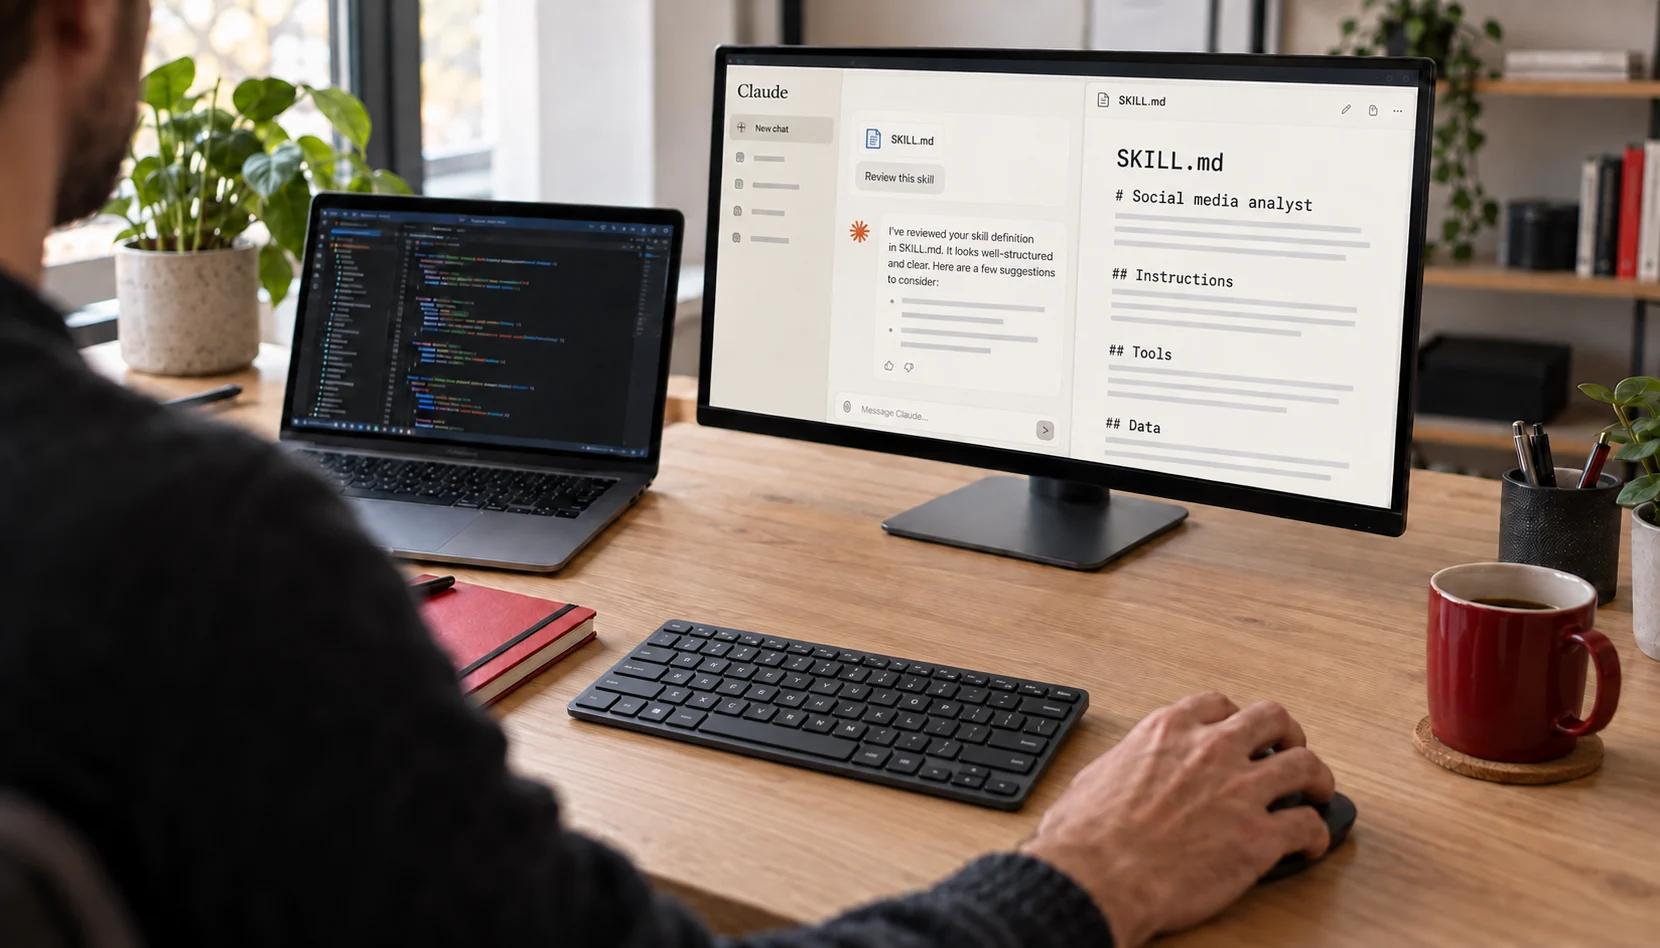
A nostro avviso, i file delle skill sono prompt con una veste più elaborata. Prendono istruzioni che altrimenti copiereste e incollereste, le organizzano in un file strutturato e ne facilitano il riutilizzo.
È utile. Potete definire un processo una volta, richiamarlo e migliorarlo con l’esperienza. Una skill può spiegare quali strumenti usare, dove si trovano i dati e come valutare il risultato.
Ma il file è solo una parte del sistema. Se un agente ha bisogno di dati aziendali aggiornati, quei dati vanno raccolti e archiviati. Se serve un calcolo, qualcosa deve eseguirlo. Se il lavoro deve avvenire ogni giorno, un processo attivo deve avviarlo.
Queste componenti meritano la stessa attenzione delle istruzioni. Diremmo anzi che ne meritano molta di più del file della skill stesso. Dovrebbero anche poter funzionare indipendentemente dall’assistente AI usato dalla vostra azienda.
Che cos’è SKILL.md e a cosa servono le Claude Skills?
SKILL.md è il file di ingresso di una skill per agenti. Descrive quando la skill è pertinente e come l’agente dovrebbe affrontare il compito. Le Claude Skills possono includere anche script, modelli di documento e materiale di riferimento. 1 2
Una skill per l’analisi dei social media potrebbe, per esempio, chiedere all’agente di leggere il contesto aziendale, recuperare l’attività dei concorrenti, confrontare i risultati e proporre idee di contenuto con le relative fonti.
Uno script incluso può occuparsi di una parte del lavoro. Ma aggiungere la skill a Claude o ChatGPT non crea, di per sé, un archivio condiviso né un processo di raccolta che continui dopo la chiusura della conversazione.
Per un’attività aziendale, verificate quali sistemi la skill può davvero consultare e in quali può eseguire azioni.
La raccolta periodica dei dati dovrebbe funzionare da sola
Stiamo sviluppando un agente per i social media di Swiss Product Studio. Gli servono post dei concorrenti, informazioni sui loro account e misurazioni raccolte in momenti noti.
Non c’è un buon motivo per chiedere a un modello linguistico di decidere, ogni poche ore, di recuperare gli stessi account e salvare i risultati. Una volta definite le fonti e le regole, si tratta di una normale attività di automazione.
Può occuparsene un workflow n8n pianificato. Oppure un programma di raccolta sviluppato su misura e ospitato nel cloud. L’importante è avere un processo attivo che recuperi i dati, gestisca gli errori e registri il risultato. Il nodo Schedule Trigger di n8n, per esempio, avvia i workflow a intervalli o orari prestabiliti. 3
Interrogare un endpoint noto, controllare gli identificativi, eliminare i duplicati e salvare i record sono operazioni che possono avvenire senza chiamare un modello linguistico. La normale raccolta dei dati non richiede crediti Claude o OpenAI.
Usate l’AI dove l’interpretazione è utile: per comprendere uno schema nei dati, valutare una fonte o sviluppare un’idea. Nel frattempo, il programma di raccolta può continuare a svolgere il proprio compito in background.
I dati aziendali hanno bisogno di un archivio condiviso
Dove finiscono i dati dopo la raccolta?
Per un esperimento, salvare file sul portatile è comodo. Per un processo aziendale utilizzato da più persone, agenti e strumenti, un database condiviso offre una base più utile.
L’agente per i social media può leggere gli stessi record di una dashboard. Un altro assistente può usarli per un rapporto. Un’applicazione autorizzata può renderli accessibili da un computer o da un telefono, senza dipendere da una particolare conversazione o dal computer di una sola persona.
La cronologia rimane disponibile anche quando cambia l’assistente. Oggi l’azienda potrebbe usare Claude e tra sei mesi un agente basato su OpenAI. Un database gestito separatamente e un processo di raccolta indipendente offrono a entrambi la stessa base di lavoro.
Potrebbe essere necessario adattare un connettore o l’interfaccia di uno strumento. Non dovreste però raccogliere di nuovo tutta la cronologia aziendale solo perché avete cambiato il modello che la consulta.
Un buon modello dati rende utili i record
Un database richiede più attenzione di un semplice spazio in cui salvare l’output della raccolta. Il modello dati definisce che cosa rappresentano i record e come sono collegati.
Per l’agente del nostro studio abbiamo separato il brand da promuovere, le aziende o persone monitorate, i loro account social, i post e le osservazioni raccolte per ciascun post.
La data di pubblicazione di un post e quella di raccolta di una metrica sono fatti diversi. Conservarle separatamente permette all’agente di distinguere un post pubblicato ieri da un post più vecchio misurato ieri. Osservazioni ripetute consentono poi confronti nel tempo.
Contano anche le relazioni. Un’azienda può avere più account. Un account può pubblicare molti post. Un post può avere più misurazioni. Identificativi stabili collegano i record senza chiedere al modello di associare di nuovo i nomi a ogni richiesta.
Nella prima analisi abbiamo trovato anche un post personale nel feed di un’azienda. Prima di confrontarne le interazioni con il numero di follower dell’azienda, dovevamo verificare chi l’avesse scritto. I record e i riferimenti alle fonti hanno reso possibile il controllo. Una buona istruzione, da sola, non avrebbe fornito l’attribuzione mancante.
Lo stesso ragionamento vale per clienti, fatture, progetti e riunioni. Definite entità, relazioni, date e regole aziendali in modo che l’agente possa interrogare record significativi. AWS indica la terminologia condivisa, le relazioni e le definizioni delle metriche come parte del contesto aziendale necessario agli agenti per capire i dati. 4
Lasciate eseguire i calcoli a SQL
Se i dati numerici sono in un database, usate il database per i calcoli.
Un agente può tradurre una domanda come «Quale di questi account aveva il tasso di interazione mediano più alto il mese scorso?» in una query adatta, oppure chiamare uno strumento che esegue un calcolo concordato. SQL filtra i record, collega le tabelle pertinenti e calcola il risultato. Il modello linguistico può poi spiegarlo.
Ottenete così un calcolo verificabile e ripetibile. PostgreSQL offre funzioni di aggregazione per conteggi, somme, medie e calcoli statistici, oltre a tipi numerici per valori che richiedono una precisione definita. 5 6
La query e la definizione aziendale devono comunque essere corrette. Dividere le interazioni di un post personale per i follower di un’azienda resta un confronto sbagliato, anche se SQL esegue l’operazione perfettamente.
Per la nostra analisi dei social media abbiamo usato uno script di calcolo e verificato i risultati in modo indipendente con SQL. Il principio è lo stesso: eseguire i calcoli nel software, invece di chiedere al modello linguistico di produrre un numero dal proprio ragionamento.
Una skill può documentare la formula e le condizioni d’uso. Una query testata o uno strumento di calcolo svolge il lavoro.
Database vettoriale, embedding vettoriali e RAG
Consideriamo ora le trascrizioni delle riunioni. Con centinaia di conversazioni lunghe, fornire di nuovo tutto il testo grezzo a un assistente per ritrovare una sola discussione non è una buona scelta predefinita.
Potete conservare le trascrizioni originali, dividerle in sezioni utili e salvare ogni sezione con l’identificativo della riunione, la data, le informazioni su chi parla e un riferimento alla posizione nel testo originale. Gli embedding vettoriali, o vector embeddings, rappresentano il significato del testo sotto forma di numeri. Aiutano il sistema a trovare sezioni pertinenti anche quando la domanda usa parole diverse. La ricerca per parole chiave può affiancare questa ricerca semantica. 7
Gli embedding possono essere conservati in un database vettoriale o in un database relazionale con supporto per i vettori. 7
Questo supporta la retrieval-augmented generation (RAG), o generazione aumentata tramite recupero: il sistema recupera informazioni aziendali pertinenti e le fornisce al modello linguistico come contesto per la risposta. Gli embedding vettoriali aiutano a trovare le informazioni. RAG indica il processo più ampio che usa le informazioni recuperate per generare una risposta. 4
Per esempio, una domanda sulle obiezioni di un cliente relative al prezzo può prima limitare la ricerca alle riunioni di quel cliente e poi recuperare le sezioni pertinenti. L’agente può usarle per rispondere e rimandare alle trascrizioni originali quando qualcuno vuole verificare il contesto.
Anche questa è una decisione sul modello dati: come organizzare il testo, quali metadati lo collegano all’attività aziendale e come controllare l’accesso. Per pochi documenti può bastare una normale ricerca testuale. Un archivio più ampio e vario può beneficiare della ricerca semantica o ibrida.
La generazione di embedding vettoriali può usare a sua volta un modello e comportare un costo. È una fase di elaborazione distinta e definita, invece di chiedere all’agente conversazionale di rileggere l’intero archivio a ogni domanda.
Mantenete i sistemi indipendenti dall’assistente
L’architettura a cui punteremmo separa quattro responsabilità:
| Componente | Compito |
|---|---|
| Processi pianificati | Raccogliere e aggiornare i dati secondo regole definite |
| Database condiviso | Conservare record, relazioni, riferimenti alle fonti e cronologia |
| Strumenti | Recuperare i dati autorizzati, eseguire calcoli e svolgere azioni controllate |
| Skill | Spiegare all’agente come usare queste capacità per un compito specifico |
Con queste componenti, assistenti diversi possono lavorare con gli stessi sistemi aziendali. Claude può analizzare i dati oggi. Un agente basato su OpenAI può usarli in seguito. Una dashboard può interrogarli senza coinvolgere alcun modello linguistico.
Questa separazione rende più semplice anche migliorare la skill. Potete affinare i passaggi dell’analisi, aggiungere un esempio migliore o cambiare il formato dell’output atteso, mentre il programma di raccolta continua a funzionare e il database conserva la cronologia.
La skill diventa così un modo riutilizzabile di lavorare con il sistema che avete costruito.
Migliorate la skill insieme al sistema
Le skill sono utili. Rendono le procedure più facili da condividere, ripetere e rivedere. Ma costruire un agente affidabile significa anche decidere quali attività affidare alla normale automazione, dove risiedono i dati aziendali e quali strumenti li rendono accessibili.
Per l’agente del nostro studio, il valore nasce dal collegamento tra queste componenti: processi di raccolta, record strutturati, analisi riproducibili e istruzioni che aiutano l’assistente a trasformare i risultati in proposte utili.
Partite da un compito e identificate la fonte dei dati, la frequenza di raccolta, l’archivio e gli strumenti necessari. Continuate a migliorare il file della skill mentre questi sistemi restano utili anche dopo la fine della conversazione o un cambio di modello.
Fonti
- Anthropic: preparare gli agenti a compiti reali con Agent Skills. Istruzioni, caricamento progressivo e script inclusi. ↑1
- Specifica Agent Skills. File di ingresso obbligatorio e risorse facoltative. ↑1
- n8n: Schedule Trigger. Esecuzione di workflow pubblicati a intervalli e orari definiti. ↑1
- AWS: costruire una base dati per l’AI agentica. Relazioni, definizioni delle metriche, aggiornamento e significato aziendale. ↑1 ↑2
- PostgreSQL: funzioni di aggregazione. Calcoli su insiemi di record. ↑1
- PostgreSQL: tipi numerici. Interi, numeri esatti e numeri in virgola mobile. ↑1
- Supabase: ricerca semantica. Embedding, ricerca per significato e combinazione con la ricerca per parole chiave. ↑1 ↑2